Bases de datos en Java: JDBC
Índice
Java provee una API denominada JDBC, del inglés Java DataBase Connectivity, que ha ido evolucionando a lo largo de las diferentes versiones de Java. En todo caso, es la API que permite a un programa escrito en Java conectarse a bases de datos relacionales para obtener datos, modificarlos, borrarlos o insertar nuevos datos.
Historia
Es importante detenerse un momento para comprender cómo ha evolucionado JDBC porque, en Internet y otros recursos, vas a encontrar soluciones que están desfasadas u obsoletas que debes evitar en tus nuevos programas escritos con Java.
Tradicionalmente han existido 4 tipos o formas de conectarse y operar con una base de datos en Java. Se llaman tipos porque en todos los casos se usa JDBC de fondo:
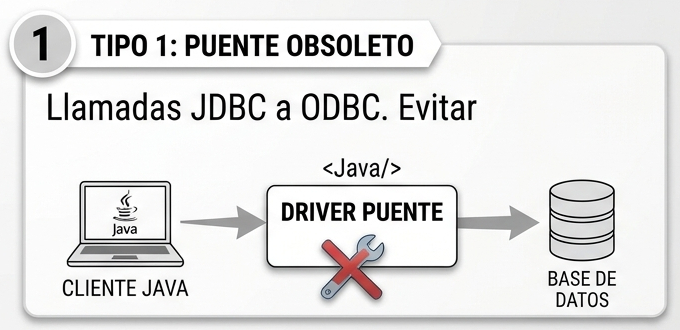
Tipo 1. Puente JDBC-ODBC: en esta opción se traducen las llamadas JDBC a ODBC, que es otra API estándar de acceso a bases de datos relacionales desarrollada por Microsoft.
Proporcionaba acceso inmediato a múltiples fuentes de datos sin configuración extra pero, por contra, es muy lento y requiere instalación ODBC previa en el equipo. Está completamente obsoleto y eliminado de Java moderno.
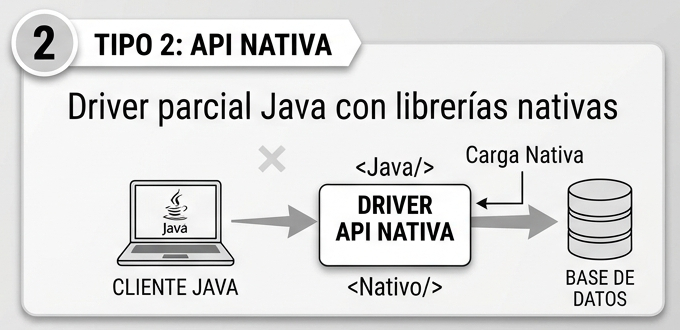
Tipo 2. API nativa / binaria: se usa un driver parcialmente en Java que utiliza librerías binarias nativas del SGBD en el cliente.
Presenta un mejor rendimiento que el puente ODBC pero requiere instalar y configurar el código binario nativo en cada máquina del cliente. Es residual y apenas se usa en nichos muy concretos.
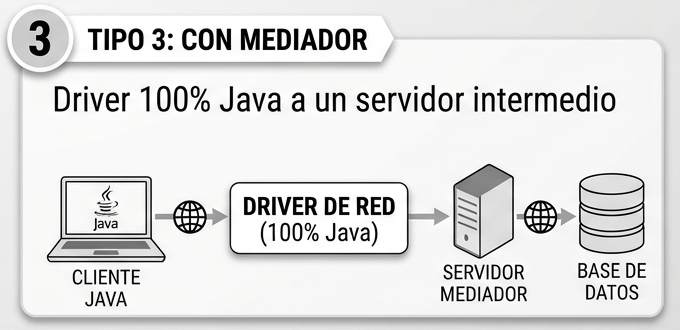
Tipo 3. 100% Java / Protocolo independiente (Middleware): driver Java que envía peticiones a un servidor intermedio, el cual las traduce al SGBD final.
Permite independencia respecto al servidor final, pero requiere desplegar y mantener una arquitectura de servidor intermedia adicional. Su uso actual es muy minoritario en aplicaciones estándar.
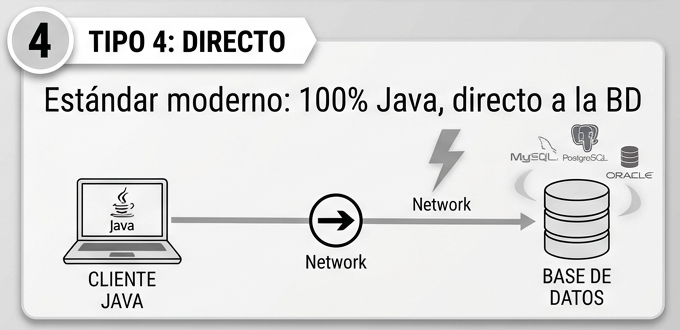
Tipo 4. 100% Java / Protocolo nativo (Directo): Driver escrito íntegramente en Java que se comunica directamente por red con el servidor SGBD usando el protocolo nativo de esa base de datos.
Es independiente de la plataforma (100% escrito en Java), rápido y no requiere librerías nativas en el cliente.
Un ejemplo claro es MySQL Connector/J o el driver de PostgreSQL. Esta es la opción que verás y usarás en el 99% de los proyectos reales de hoy en día, siendo el estándar absoluto que aprenderemos a utilizar.
Panorama actual: los niveles de abstracción
En lugar de la taxonomía de 4 tipos, hoy en día se piensa en capas. Un programa Java moderno elige en qué capa quiere situarse:
JDBC puro: se usa directamente JDBC, protocolo nativo, escribiendo directamente las sentencias SQL y con control total de SQL.
Aquí usamos los paquetes
java.sqlyjavax.sql,DataSourceyPreparedStatement.- Helper ligero: se puede usar SQL directo pero usando clases como
JdbcClientyJdbcTemplateque ayudan a automatizar ciertas acciones sin repetir como la gestión de la conexión y el cierre de la base de datos. - Mapper intermedio: se usa SQL con anotaciones lo que introduce un nivel de abstracción que evita escribir consultas SQL de forma estricta.
- ORM / JPA: aquí se usa una abstracción mayor con librerías/dependencias como Hibernate, EclipseLink o Spring Data JPA.
En este tema nos vamos a centrar en JDBC puro. En temas posteriores entraremos con ORM.
Pasos para empezar a desarrollar aplicaciones Java que se conecten a bases de datos
Para poner en marcha nuestra primera aplicación conectada a una base de datos relacional mediante JDBC puro, seguiremos siempre una secuencia lógica de pasos:
Decidir SGBD:
Disponemos de varias opciones de SGBD relacionales y, además, tenemos que decidir entre:
- SGBD relacionales basadas en servidor como: MySQL / MariaDB, PostgreSQL, Oracle o SQL Server.
- SGBD relacionales embebidas en memoria o fichero como: SQLite o H2.
Una vez hemos decidido el motor de base de datos, el SGBD, podemos pasar al segundo paso.
Añadir la dependencia del driver (Tipo 4):
Antes de escribir código, debemos asegurar que el driver correspondiente (por ejemplo, el conector de MySQL, PostgreSQL o SQLite) está disponible en el proyecto, ya sea descargando el archivo
.jare incluyéndolo en el classpath, o gestionándolo mediante herramientas de construcción como Maven o Gradle.Aquí tienes los drivers de los SGBD más populares:
Motor Driver Clase / artefacto MariaDB MariaDB Connector/J org.mariadb.jdbc:mariadb-java-clientMySQL MySQL Connector/J com.mysql:mysql-connector-jPostgreSQL pgJDBC org.postgresql:postgresqlOracle ojdbc11 com.oracle.database.jdbc:ojdbc11SQL Server Microsoft JDBC Driver com.microsoft.sqlserver:mssql-jdbcSQLite SQLite JDBC org.xerial:sqlite-jdbcH2 H2 org.h2database:h2En nuestro caso usaremos Gradle y, por tanto, tendremos que añadirlo vía
dependencies. Por ejemplo, en el caso de MariaDB añadiríamos a nuestrobuild.settings.kts:implementation("org.mariadb.jdbc:mariadb-java-client:4.0.0")Establecer los parámetros de conexión:
Necesitamos definir la URL de conexión (que indica el protocolo, el servidor, el puerto y el nombre de la base de datos), así como las credenciales de acceso (usuario y contraseña).
Obtener la conexión:
Utilizar la clase
DriverManagero unDataSourcepara abrir el canal de comunicación físico con el servidor de base de datos a través de un objetoConnection.Preparar y ejecutar la sentencia SQL:
Crear un objeto
StatementoPreparedStatement(este último altamente recomendable por seguridad frente a inyecciones SQL y rendimiento) para enviar consultas o modificaciones a la base de datos.Procesar el resultado:
Si la operación es una consulta (
SELECT), recorreremos el objetoResultSetresultante para extraer y transformar los datos en objetos o estructuras que Java pueda manipular.Liberar y cerrar recursos:
Es obligatorio cerrar adecuadamente los objetos abiertos (
ResultSet,StatementyConnection) al finalizar su uso para evitar fugas de memoria y bloqueos en el servidor. En Java moderno esto lo resolvemos de forma limpia utilizando bloquestry-with-resources.